
8.4.1 变量间的两类关系
Section titled “8.4.1 变量间的两类关系”早在 19 世纪,英国生物学家兼统计学家高尔顿(Galton)在研究父与子身高的遗传问题时,观察了 1078 对父与子,用 x 表示父亲身高,y 表示成年儿子的身高,发现将 (x, y) 点在直角坐标系中,这 1078 个点基本在一条直线附近,并求出了该直线的方程 (单位: 英寸, 1 英寸 = 2.54 cm):
hat y = 3 3. 7 3 + 0. 5 1 6 x.这表明: - 父亲身高每增加 1 个单位,其儿子的身高平均增加 0.516 个单位. - 高个子父辈生的儿子平均身高也高,但子辈的身高间的差距低于父辈间的身高差距(为0.516倍). 这便是子代的平均高度有向中心回归的趋势,使得一段时间内人的身高相对稳定.之后回归分析的思想渗透到了数理统计的其他分支中.随着计算机的发展,各种统计软件包的出现,回归分析的应用就越来越广泛. 回归分析处理的是变量与变量间的关系.变量间常见的关系有两类: 一类称为确定性关系: 这些变量间的关系是完全确定的,可以用函数 y = f(x) 来表示,x (可以是向量) 给定后,y 的值就唯一确定了.譬如正方形的面积 S 与边长 a 之间有关系 S = a²,电路中有欧姆定律 V = IR 等.另一类称为相关关系: 变量间有关系,但是不能用函数来表示.譬如,人的身高 x 与体重 y 两者间有相关关系,一般来讲,身高较高的人体重也较重,但是同样身高的人的体重可以是不同的,医学上就利用这两个变量间的相关关系,给出了一些经验公式来确定一个人是否过于“肥胖”或“瘦小”; 人的脚掌的长度 x 与身高 y 两者间也有相关关系,一般来讲,脚掌较长的人身高也较高,但是同样脚掌长度的人的身高可以是不同的,早期公安机关在破案时,常常根据罪犯留下的脚印来推测罪犯的身高. 变量间的相关关系不能用完全确定的函数形式表示,但在平均意义下有一定的定量关系表达式,寻找这种定量关系表达式就是回归分析的主要任务. 回归分析便是研究变量间相关关系的一门学科.它通过对客观事物中变量的大量观察或试验获得的数据,去寻找隐藏在数据背后的相关关系,给出它们的表达形式——回归函数的估计.
8.4.2 一元线性回归模型
Section titled “8.4.2 一元线性回归模型”设 y 与 x 间有相关关系,称 x 为自变量 (预报变量), y 为因变量 (响应变量), 在知道 x 取值后,y 的取值并不是确定的,它是一个随机变量,因此有一个分布,这个分布是在知道 x 的取值后 Y 的条件密度函数 p(y|x),我们关心的是 y 的均值 E(Y|x),它是 x 的函数,这个函数是确定性的:
f (x) = E (Y | x) = ∫_ - ∞ ^ ∞ y p (y | x) d y. (8.4.1)这便是 y 关于 x 的回归函数——条件期望,也就是我们要寻找的相关关系的表达式. 以上的叙述是在 x 与 y 均为随机变量场合进行的,这是一类回归问题.实际中还有第二类回归问题,其自变量 x 是可控变量 (一般变量), 只有 y 是随机变量,它们之间的相关关系可用下式表示:
y = f (x) + ε ,其中 ε 是随机误差,一般假设 ε ∼ N(0, σ²).由于 ε 的随机性,导致 y 是随机变量.本节主要研究第二类回归问题. 进行回归分析首先是回归函数形式的选择,当只有一个自变量时,通常可采用画散点图的方法进行选择,具体见下例.
由专业知识知道,合金钢的强度 y (单位: 10⁷ Pa) 与合金钢中碳的含量 x (单位:%) 有关.为了生产强度满足用户需要的合金钢,在冶炼时如何控制碳的含量?如果在冶炼过程中通过化验得知了碳的含量,能否预测这炉合金钢的强度? 为解决这类问题就需要研究两个变量间的关系.首先是收集数据,我们把收集到的数据记为 (xᵢ,yᵢ)(i=1,2,…,n).本例中,我们收集到12组数据,列于表8.4.1中. 表 8.4.1 合金钢强度 y 与碳含量 x 的数据
| 序号 | x | y | 序号 | x | y |
| 1 | 0.10 | 42.0 | 7 | 0.16 | 49.0 |
| 2 | 0.11 | 43.0 | 8 | 0.17 | 53.0 |
| 3 | 0.12 | 45.0 | 9 | 0.18 | 50.0 |
| 4 | 0.13 | 45.0 | 10 | 0.20 | 55.0 |
| 5 | 0.14 | 45.0 | 11 | 0.21 | 55.0 |
| 6 | 0.15 | 47.5 | 12 | 0.23 | 60.0 |

从散点图我们可以看出,12个点基本在一条直线附近,这说明两个变量之间有一个线性相关关系,若记y轴方向上的误差为 ε,这个相关关系可以表示为
y = β_ 0 + β_ 1 x + ε . (8.4.2)这便是 y 关于 x 的一元线性回归的数据结构式.这里总假定 x 为一般变量,是非随机变量,其值是可以精确测量或严格控制的,β₀, β₁ 为未知参数,β₁ 是直线的斜率,它表示 x 每增加一个单位 E(y) 的增加量.ε 是随机误差,通常假定
E (ε) = 0, Var (ε) = σ^ 2, (8.4.3)在对未知参数作区间估计或假设检验时,还需要假定误差服从正态分布,即
y ∼ N (β_ 0 + β_ 1 x, σ^ 2). (8.4.4)显然,假定(8.4.4)比(8.4.3)要强. 由于 β₀, β₁ 均未知,需要我们从收集到的数据 (xᵢ, yᵢ) (i = 1, 2, …, n) 出发进行估计.在收集数据时,我们一般要求观测独立地进行,即假定 y₁, y₂, …, yₙ 相互独立.综合上述诸项假定,我们可以给出最简单、常用的一元线性回归的统计模型
{ l l y _ i = β_ 0 + β_ 1 x _ i + ε_ i, & i = 1, 2, … , n, text 各 ε_ i text 独立同分布,其分布为 N (0, σ^ 2). . (8.4.5)由数据 (xᵢ,yᵢ)(i=1,2,…,n) 可以获得 β₀,β₁ 的估计 hatβ₀,hatβ₁ ,称
hat y = hat β _ 0 + hat β _ 1 x (8.4.6)为 y 关于 x 的经验回归函数,简称为回归方程,其图形称为回归直线.给定 x = x₀ 后,称 haty₀ = hatβ₀ + hatβ₁ x₀ 为回归值 (在不同场合也称其为拟合值、预测值).
8.4.3 回归系数的最小二乘估计
Section titled “8.4.3 回归系数的最小二乘估计”一般采用最小二乘方法估计模型(8.4.5)中的 β₀,β₁.令
Q (β_ 0, β_ 1) = ∑_ i = 1 ^ n (y _ i - β_ 0 - β_ 1 x _ i) ^ 2,hatβ₀, hatβ₁ 应该满足
Q (hat β _ 0, hat β _ 1) = min _ β_ 0, β_ 1 Q (β_ 0, β_ 1),这样得到的 hatβ₀,hatβ₁ 称为 β₀,β₁ 的最小二乘估计,记为LSE. 由于 Q ≥slant 0 ,且对 β₀, β₁ 的导数存在,因此最小二乘估计可以通过求偏导数并命其为0而得到
{ l frac ∂ Q∂ β_ 0 = - 2 ∑_ i = 1 ^ n (y _ i - β_ 0 - β_ 1 x _ i) = 0, frac ∂ Q∂ β_ 1 = - 2 ∑_ i = 1 ^ n (y _ i - β_ 0 - β_ 1 x _ i) x _ i = 0. . (8.4.7)这组方程称为正规方程组,经过整理,可得
{ l n β_ 0 + n bar x β_ 1 = n bar y, n bar x β_ 0 + ∑ x _ i ^ 2 β_ 1 = ∑ x _ i y _ i, . (8.4.8)(今后凡是不作说明“Σ”都表示“ ∑ᵢ=1ⁿ ”)记
overline x = frac 1n ∑ x _ i, overline y = frac 1n ∑ y _ i, l _ x y = ∑ (x _ i - overline x) (y _ i - overline y) = ∑ x _ i y _ i - n overline x · overline y = ∑ x _ i y _ i - frac 1n ∑ x _ i ∑ y _ i, l _ x x = ∑ (x _ i - overline x) ^ 2 = ∑ x _ i ^ 2 - n overline x ^ 2 = ∑ x _ i ^ 2 - frac 1n (∑ x _ i) ^ 2, l _ y y = ∑ (y _ i - overline y) ^ 2 = ∑ y _ i ^ 2 - n overline y ^ 2 = ∑ y _ i ^ 2 - frac 1n (∑ y _ i) ^ 2.解(8.4.8)可得
{ l hat β _ 1 = frac l _ x yl _ x x, hat β _ 0 = bar y - hat β _ 1 bar x. . (8.4.9)这就是参数的最小二乘估计,其计算通常可列表进行,见表8.4.2.
使用例8.4.1 中合金钢强度和碳含量数据,我们可求得回归方程,见表 8.4.2. 表 8.4.2 合金钢强度和碳含量数据的计算表
| ∑ xᵢ = 1.90 | n = 12 | ∑ yᵢ = 589.5 |
| overlinex = 0.158 3 | overliney = 49.125 | |
| ∑ xᵢ² = 0.319 4 | ∑ xᵢyᵢ = 95.805 | ∑ yᵢ² = 29 304.25 |
| n overlinex² = 0.300 8 | n overlinex overliney = 93.337 5 | n overliney² = 28 959.19 |
| lₓx = 0.018 6 | lₓy = 2.467 5 | l_(yy) = 345.06 |
| hatβ₁ = lₓy/lₓx = 132.66 | ||
| hatβ₀ = overliney - hatβ₁ overlinex = 28.12 |
关于最小二乘估计的一些性质罗列在如下定理之中:
在模型(8.4.5)下,有 (1) hatβ₀ ∼ N(β₀, (1/n + fracoverlinex²lₓx) σ²) , hatβ₁ ∼ N(β₁, fracσ²lₓx) ; (2) operatornameCov(hatβ₀, hatβ₁) = -fracbarxlₓx σ²; (3)对给定的 x₀, haty₀ = hatβ₀ + hatβ₁ x₀ ∼ N(β₀ + β₁ x₀, (1/n + frac(x₀ - barx)²lₓx) σ²) .
证明
利用 ∑ (xᵢ - overlinex) = 0 ,可把 hatβ₁ 和 hatβ₀ 改写为
hat β _ 1 = frac l _ x yl _ x x = ∑ frac x _ i - bar xl _ x x y _ i,hat β _ 0 = overline y - hat β _ 1 overline x = ∑ [ frac 1n - frac (x _ i - overline x) overline xl _ x x ] y _ i.它们是独立正态变量 y₁, y₂, …, yₙ 的线性组合,故都服从正态分布,下面分别求其期望与方差.
E (hat β _ 1) = ∑ frac x _ i - bar xl _ x x E (y _ i) = ∑ frac x _ i - bar xl _ x x (β_ 0 + β_ 1 x _ i) = β_ 1,operatornameVar (hat boldsymbol β _ 1) = ∑ (frac x _ i - bar xl _ x x) ^ 2 operatornameVar (y _ i) = ∑ frac (x _ i - bar x) ^ 2l _ x x ^ 2 σ^ 2 = frac σ^ 2l _ x x,E (hat β _ 0) = E (bar y) - E (hat β _ 1) bar x = β_ 0 + β_ 1 bar x - β_ 1 bar x = β_ 0,operatornameVar (hat β _ 0) = ∑ [ frac 1n - frac (x _ i - bar x) bar xl _ x x ] ^ 2 operatornameVar (y _ i) = (frac 1n + frac bar x ^ 2l _ x x) σ^ 2,这就证明了(1).进一步,考虑到诸 yᵢ 之间的独立性,可得
operatornameCov (hat boldsymbol β _ 0, hat boldsymbol β _ 1) = operatornameCov (∑ [ frac 1n - frac (x _ i - bar x) bar xl _ x x ] y _ i, ∑ frac x _ i - bar xl _ x x y _ i) = ∑ [ frac 1n - frac (x _ i - bar x) bar xl _ x x ] frac x _ i - bar xl _ x x σ^ 2 = - frac bar xl _ x x σ^ 2,这就证明了(2).为证明(3),注意到 haty₀=hatβ₀+hatβ₁x₀ 也是 y₁,y₂,…,yₙ 的线性组合,它也服从正态分布,只需求出其期望与方差即可.
E (hat y _ 0) = E (hat β _ 0) + E (hat β _ 1) x _ 0 = β_ 0 + β_ 1 x _ 0 = E (y _ 0),r l Var (hat y _ 0) & = Var (hat β _ 0) + Var (hat β _ 1) x _ 0 ^ 2 + 2 Cov (hat β _ 0, hat β _ 1) x _ 0 & = [ (frac 1n + frac overline x ^ 2l _ x x) + frac x _ 0 ^ 2l _ x x - 2 frac x _ 0 overline xl _ x x ] σ^ 2 = [ frac 1n + frac (x _ 0 - overline x) ^ 2l _ x x ] σ^ 2,证明完成.
定理8.4.1说明: - hatβ₀,hatβ₁ 分别是 β₀,β₁ 的无偏估计; - haty₀ 是 E(y₀) = β₀ + β₁x₀ 的无偏估计. - 除 overlinex = 0 外,hatβ₀ 与 hatβ₁ 是相关的. - 要提高 hatβ₀, hatβ₁ 的估计精度(即降低它们的方差)就要求 n 大, lₓx 大(即要求 x₁, x₂, …, xₙ 较分散).
8.4.4 回归方程的显著性检验
Section titled “8.4.4 回归方程的显著性检验”从回归系数的 LSE 可以看出,对任意给出的 n 对数据 (xᵢ, yᵢ),都可以求出 hatβ₀, hatβ₁ 从而可写出回归方程 haty = hatβ₀ + hatβ₁x ,但是这样给出的回归方程不一定有意义. 在使用回归方程以前,首先应对回归方程是否有意义进行判断.什么叫回归方程有意义呢?我们知道,建立回归方程的目的是寻找y的均值随x变化的规律,即找出回归方程 E(y)=β₀+β₁x.如果 β₁=0,那么不管x如何变化, E(y)不随x的变化作线性变化,那么这时求得的一元线性回归方程就没有意义,或称回归方程不显著.如果 β₁≠0,那么当x变化时, E(y)随x的变化作线性变化,那么这时求得的回归方程就有意义,或称回归方程是显著的. 综上,对回归方程是否有意义作判断就是要对如下的检验问题作出判断:
H _ 0: β_ 1 = 0 vs H _ 1: β_ 1 ≠ 0, (8.4.10)拒绝 H₀ 表示回归方程是显著的. 在一元线性回归中有三种等价的检验方法,使用中只要任选其中之一即可.下面分别加以介绍.
一、 F 检验
Section titled “一、 FF 检验”采用方差分析的思想,我们从数据出发研究各 yᵢ 不同的原因.首先引入记号并称 hatyᵢ=hatβ₀+hatβ₁xᵢ 为 xᵢ 处的回归值,又称 yᵢ-hatyᵢ 为 xᵢ 处的残差. 数据总的波动用总偏差平方和
S _ T = ∑ (y _ i - bar y) ^ 2 = l _ y y表示.引起各 yᵢ 不同的原因主要有两类因素:其一是 H₀ 可能不真,即 β₁ ≠ 0 ,从而 E(y) = β₀ + β₁x 随 x 的变化而变化,即在每一个 x 的观测值处的回归值不同,其波动用回归平方和
S _ R = ∑ (hat y _ i - overline y) ^ 2 (8.4.11)表示;其二是其他一切因素,包括随机误差、x 对 E(y) 的非线性影响等,这样在得到回归值以后,y 的观测值与回归值之间还有差距,这可用残差平方和
S _ e = ∑ (y _ i - hat y _ i) ^ 2 (8.4.12)表示. 为对上述诸平方和实施方差分析,下面我们要证明重要的平方和分解式,为此首先注意到 hatβ₀,hatβ₁ 满足正规方程组(8.4.7),因此有
r l & ∑ (y _ i - hat β _ 0 - hat β _ 1 x _ i) = 0 ⇒ ∑ (y _ i - hat y _ i) = 0, & ∑ (y _ i - hat β _ 0 - hat β _ 1 x _ i) x _ i = 0 ⇒ ∑ (y _ i - hat y _ i) x _ i = 0.利用 hatyᵢ = hatβ₀ + hatβ₁xᵢ = overliney +hatβ₁(xᵢ - overlinex) ,可得
∑ (y _ i - hat y _ i) (hat y _ i - bar y) = ∑ (y _ i - hat y _ i) [ hat β _ 1 (x _ i - bar x) ] = hat β _ 1 [ ∑ (y _ i - hat y _ i) x _ i - ∑ (y _ i - hat y _ i) bar x ] = 0,从而
S _ T = ∑ (y _ i - bar y) ^ 2 = ∑ (y _ i - hat y _ i + hat y _ i - bar y) ^ 2 = ∑ (y _ i - hat y _ i) ^ 2 + ∑ (hat y _ i - bar y) ^ 2,即
S _ T = S _ R + S _ e, (8.4.13)上式就是一元线性回归场合下的平方和分解式. 关于 S_(R) 和 Sₑ 所含有的成分可由如下定理说明.
设 yᵢ=β₀+β₁xᵢ+εᵢ ,其中 ε₁,ε₂,…,εₙ 相互独立,且
E (ε_ i) = 0, operatornameVar (ε_ i) = σ^ 2, i = 1, 2, … , n,沿用上面的记号,有
l E (S _ R) = σ^ 2 + β_ 1 ^ 2 l _ x x, E (S _ e) = (n - 2) σ^ 2, (8.4.14)(8.4.15) (8.4.15)式说明 hatσ²=Sₑ/(n-2) 是 σ² 的无偏估计.
证明
首先我们可以写出 S_(R) 的简化公式:
S _ R = ∑ (hat y _ i - bar y) ^ 2 = ∑ [ bar y + hat β _ 1 (x _ i - bar x) - bar y ] ^ 2 = hat β _ 1 ^ 2 l _ x x, (8.4.16)从而
E (S _ R) = E (hat β _ 1 ^ 2) l _ x x = [ operatornameVar (hat β _ 1) + (E (hat β _ 1)) ^ 2 ] l _ x x = (frac σ^ 2l _ x x + β_ 1 ^ 2) l _ x x = σ^ 2 + β_ 1 ^ 2 l _ x x,这就证明了(8.4.14).另外
r l S _ e & = ∑ (y _ i - hat y _ i) ^ 2 = ∑ (β_ 0 + β_ 1 x _ i + ε_ i - hat β _ 0 - hat β _ 1 x _ i) ^ 2 & = ∑ [ (hat β _ 0 - β_ 0) ^ 2 + x _ i ^ 2 (hat β _ 1 - β_ 1) ^ 2 + ε_ i ^ 2 + 2 (hat β _ 0 - β_ 0) (hat β _ 1 - β_ 1) x _ i - 2 (hat β _ 0 - β_ 0) ε_ i - 2 (hat β _ 1 - β_ 1) x _ i ε_ i ],故
r l E (S _ e) & = n Var (hat β _ 0) + ∑ x _ i ^ 2 Var (hat β _ 1) + n Var (ε_ i) + 2 n overline x Cov (hat β _ 0, hat β _ 1) - & 2 ∑ E (hat β _ 0 ε_ i) - 2 ∑ x _ i E (hat β _ 1 ε_ i).将 hatβ₀,hatβ₁ 写成 y₁,y₂,…,yₙ 的线性组合,利用 yⱼ 与 εᵢ(i≠ j) 的独立性,有
E (hat β _ 0 ε_ i) = E [ ε_ i ∑_ j (frac 1n - frac (x _ j - bar x) bar xl _ x x) y _ j ] = (frac 1n - frac (x _ i - bar x) bar xl _ x x) σ^ 2,E (hat β _ 1 ε_ i) = E [ ε_ i ∑_ j frac x _ j - bar xl _ x x y _ j ] = frac x _ i - bar xl _ x x σ^ 2,由此即有
∑ E (hat β _ 0 ε_ i) = σ^ 2, ∑ x _ i E (hat β _ 1 ε_ i) = σ^ 2.从而
E (S _ e) = n (frac 1n + frac overline x ^ 2l _ x x) σ^ 2 + ∑ frac x _ i ^ 2l _ x x σ^ 2 + n σ^ 2 - frac 2 n overline x ^ 2l _ x x σ^ 2 - 2 σ^ 2 - 2 σ^ 2= (1 + n - 4) σ^ 2 + frac 1l _ x x ∑ (x _ i - bar x) ^ 2 σ^ 2 = (n - 2) σ^ 2,这就完成了证明. 进一步,有关 S_(R) 和 Sₑ 的分布,有如下定理.
设 y₁, y₂, …, yₙ 相互独立,且 yᵢ ∼ N(β₀ + β₁ xᵢ, σ²) , i = 1, 2, …, n ,则在上述记号下,有 (1) Sₑ / σ²∼ χ²(n - 2) (2) 若 H₀ 成立,则有 S_(R)/σ²∼χ²(1) ; (3) S_(R) 与 Sₑ, bary 独立(或 hatβ₁ 与 Sₑ, bary 独立).
证明
取 n × n 正交矩阵 A 具有如下形式:
boldsymbol A = ( c c c c a _ 1 1 & a _ 1 2 & … & a _ 1 n vdots & vdots & & vdots a _ n - 2, 1 & a _ n - 2, 2 & … & a _ n - 2, n frac x _ 1 - bar xsqrt l _ x x & frac x _ 2 - bar xsqrt l _ x x & … & frac x _ n - bar xsqrt l _ x x frac 1sqrt n & frac 1sqrt n & … & frac 1sqrt n ),由正交性,可得如下一些约束条件:
r l ∑_ j a _ i j = 0, ∑_ j a _ i j x _ j = 0, ∑_ j a _ i j ^ 2 = 1, i = 1, 2, … , n - 2, ∑_ k a _ i k a _ j k = 0, 1 ≤slant i < j ≤slant n - 2,这里矩阵 A 共有 n(n-2) 个未知参数,约束条件有 3(n-2)+binomn-22=(n-2)(n+3)/2 个,只要 n ≥slant 3,未知参数个数就不少于约束条件数,因此正交矩阵 A 必存在.令
mathbf Z = ( c z _ 1 z _ 2 vdots z _ n ) = mathbf A mathbf Y = mathbf A ( c y _ 1 y _ 2 vdots y _ n ) = ( c ∑_ j a _ 1 j y _ j vdots ∑_ j a _ n - 2, j y _ j ∑_ j frac x _ j - bar xsqrt l _ xx y _ j ∑_ j frac 1sqrt n y _ j ),其中
r l z _ n - 1 & = frac ∑ (x _ i - overline x) y _ isqrt l _ x x = frac ∑ (x _ i - overline x) (y _ i - overline y)sqrt l _ x x = frac l _ x ysqrt l _ x x = sqrt l _ x x hat β _ 1, & z _ n = frac 1sqrt n ∑ y _ i = sqrt n overline y,则 Z 仍然服从 n 维正态分布,且其期望与协方差阵分别为
E (textbf Z) = ( c 0 vdots 0 β_ 1 sqrt l _ x x sqrt n (β_ 0 + β_ 1 overline x) ), Var (textbf Z) = A Var (textbf Y) A ^ T = σ^ 2 I _ n,这表明 z₁, z₂, …, zₙ 相互独立, z₁, z₂, …, zₙ-2 的共同分布为 N(0, σ²) , zₙ-1 ∼ N(β₁ sqrtlₓx, σ²) , zₙ ∼ N(√(n) (β₀ + β₁ barx), σ²) . 由于 ∑ zᵢ² = ∑ yᵢ² = S_(T) + noverliney² = S_(R) + Sₑ + noverliney² ,而 zₙ = √(n)overliney,zₙ - 1 = sqrtlₓxhatβ₁ = sqrtS_(R) ,于是有 z₁²+ z₂² + … +zₙ - 2² = Sₑ ,所以 Sₑ,S_(R),overliney 三者相互独立.并有
S _ e / σ^ 2 = ∑_ i = 1 ^ n - 2 (z _ i / σ) ^ 2 ∼ χ^ 2 (n - 2),在 β₁ = 0 时,
S _ R / σ^ 2 = (frac z _ n - 1σ) ^ 2 ∼ χ^ 2 (1),证明完成. 如同方差分析那样,我们可以考虑采用如下 F 作为检验问题(8.4.10)的检验统计量:
F = frac S _ RS _ e / (n - 2).在 β₁ = 0 时, F ∼ F(f_(R), fₑ) ,其中 f_(R) = 1, fₑ = n - 2.对于给定的显著性水平 α ,其拒绝域为 F ≥slant F₁ - α(1, n - 2) . 整个检验也可列成一张方差分析表.检验也可用 p 值进行.
在合金钢强度的例8.4.2 中,我们已求出了回归方程,这里我们考虑关于回归方程的显著性检验.经计算有
l l S _ T = l _ y y = 3 4 5. 0 6, & f _ T = 1 1, S _ R = hat β _ 1 ^ 2 l _ x x = 1 3 2. 6 6 ^ 2 × 0. 0 1 8 6 = 3 2 7. 3 4, & f _ R = 1, S _ e = S _ T - S _ R = 3 4 5. 0 6 - 3 2 7. 3 4 = 1 7. 7 2, & f _ e = 1 0.把各平方和与自由度移入方差分析表,继续进行计算,具体见表8.4.3. 表 8.4.3 合金钢强度与碳含量回归方程的方差分析表
| 来源 | 平方和 | 自由度 | 均方 | F比 | p值 |
| 回归 | S_R=327.34 | f_R=1 | MS_R=327.34 | 184.94 | 0.000 0 |
| 残差 | Sₑ=17.72 | fₑ=10 | MSₑ=1.77 | ||
| 总计 | S_T=345.06 | f_T=11 |
二、 t 检验
Section titled “二、 tt 检验”对 H₀: β₁ = 0 的检验也可基于 t 分布进行.由于 hatβ₁ ∼ N(β₁, fracσ²lₓx), (Sₑ)/(σ²) ∼ χ²(n - 2),且与 hatβ₁ 相互独立,因此在 H₀ 为真时,有
t = frac hat β _ 1hat σ / sqrt l _ x x ∼ t (n - 2), (8.4.17)其中 hatσ = √(Sₑ / (n - 2)) ,由于 σ_(hatβ)₁ = fracσsqrtlₓx 因此称 hatσ_(hatβ)₁ = frachatσsqrtlₓx 为 hatβ₁ 的标准误,即 hatβ₁ 的标准差的估计.(8.4.17)式表示的 t 统计量可用来检验假设 H₀.对给定的显著性水平 α ,拒绝域为
W = {| t | > t _ 1 - α / 2 (n - 2) }.意到 t²=F ,因此,t 检验与 F 检验是等同的。 以例8.4.2 中数据为例,可以计算得到
t = frac 1 3 2 . 6 6sqrt 1 . 7 7 / sqrt 0 . 0 1 8 6 = 1 3. 5 9 9 1.若取 α = 0.01 ,则 t₀.995(10) = 3.1693 ,由于13.599 1 > 3.1693 ,因此,在显著性水平0.01下回归方程是显著的.
三、相关系数检验
Section titled “三、相关系数检验”考察一元线性回归方程能否反映两个随机变量 x 与 y 间的线性相关关系时,它的显著性检验还可通过对二维总体相关系数 ρ 的检验进行.它的一对假设是
H _ 0: ρ = 0 text vs H _ 1: ρ ≠ 0. (8.4.18)所用的检验统计量为样本相关系数
r = frac ∑ (x _ i - bar x) (y _ i - bar y)sqrt ∑ (x _ i - bar x) ^ 2 ∑ (y _ i - bar y) ^ 2 = frac l _ x ysqrt l _ x x l _ y y, (8.4.19)其中 (xᵢ,yᵢ)(i=1,2,…,n) 是容量为n的二维样本. 利用施瓦茨不等式可以证明:样本相关系数也满足 |r|≤slant1,其中等号成立的条件是存在两个实数a与b,使得对 i=1,2,…,n 几乎处处有 yᵢ=a+bxᵢ.由此可见,n个点 (xᵢ,yᵢ)(i=1,2,…,n) 在散点图上的位置与样本相关系数r有关,譬如: - r = ± 1, n 个点完全在一条上升或下降的直线上. - r > 0 ,当 x 增加时, y 有线性增加趋势,此时称正相关. - r < 0,当 x 增加时,y 反而有线性减少趋势,此时称负相关. - r = 0, n 个点可能杂乱无章,也可能呈某种曲线趋势,此时称不相关. 根据样本相关系数的上述性质,检验(8.4.18)中原假设 H₀:ρ=0 的拒绝域为 W={|r|≥slant c} ,其中临界值c可由 H₀:ρ=0 成立时样本相关系数的分布定出,该分布与自由度n-2有关. 对给定的显著性水平 α ,由 P(W) = P(|r| ≥slant c) = α 知,临界值 c 应是 H₀: ρ = 0 成立下 |r| 的分布的 1 - α 分位数,故可记为 c = r₁ - α(n - 2).我们还可以用 F 分布来确定临界值 c ,下面加以叙述. 由样本相关系数的定义可以得到统计量 r 与 F 之间的关系
r ^ 2 = frac l _ x y ^ 2l _ x x l _ y y = frac S _ RS _ T = frac S _ RS _ R + S _ e = frac S _ R / S _ eS _ R / S _ e + 1,而
F = frac M S _ RM S _ e = frac S _ RS _ e / (n - 2) = frac (n - 2) S _ RS _ e.两者综合,可得
r ^ 2 = frac FF + (n - 2).这表明, |r| 是 F 的严格单调增函数,故可以从 F 分布的 1 - α 分位数 F₁ - α(1,n - 2) 得到 |r| 的 1 - α 分位数为
c = r _ 1 - α (n - 2) = sqrt frac F _ 1 - α (1 , n - 2)F _ 1 - α (1 , n - 2) + n - 2.譬如,对 α = 0.01, n = 12 ,查表知 F₀.99(1,10) = 10.04 ,于是
r _ 0. 9 9 (1 0) = sqrt frac 1 0 . 0 41 0 . 0 4 + 1 0 = 0. 7 0 7 8.为实际使用方便,人们已对 r₁-α(n-2) 编制了专门的表,见附表 9. 以例8.4.2 中数据为例,可以计算得到
r = frac 2 . 4 6 7 5sqrt 0 . 0 1 8 6 × 3 4 5 . 0 6 = 0. 9 7 4 0.若取 α=0.01 ,查附表9知则 r₀.99(10)=0.708 ,由于0.9740>0.708,因此,在显著性水平0.01下回归方程是显著的。
上述三个检验在考察一元线性回归时是等价的,但在多元线性回归场合,经推广 F 检验仍可用,另两个检验就无法使用了.
8.4.5 估计与预测
Section titled “8.4.5 估计与预测”当回归方程经过检验是显著的后,可用来作估计和预测.这是两个不同的问题: - 当 x = x₀ 时,寻求均值 E(y₀) = β₀ + β₁x₀ 的点估计与区间估计(注意这里 E(y₀) 是常量),这是估计问题. - 当 x = x₀ 时,y₀ 的观测值在什么范围内? 由于 y₀ 是随机变量,一般只求一个区间,使 y₀ 落在这一区间的概率为 1 - α,即要求 δ,使 P(|y₀ - haty₀| ≤slant δ) = 1 - α,称区间 [haty₀ - δ, haty₀ + δ] 为 y₀ 的概率为 1 - α 的预测区间,这是预测问题.
一、 E(y₀) 的估计
Section titled “一、 E(y₀)E(y0) 的估计”在 x = x₀ 时,其对应的因变量 y₀ 是一个随机变量,有一个分布,我们经常需要对该分布的均值给出估计。我们知道,该分布的均值 E(y₀) = β₀ + β₁x₀ ,因此,一个直观的估计应为
hat E (y _ 0) = hat β _ 0 + hat β _ 1 x _ 0.简单起见,我们习惯上将上述估计记为 haty₀ (注意,作为估计这里 haty₀ 表示的是 E(y₀) 的估计,而不表示 y₀ 的估计,因为 y₀ 是随机变量,它不能被估计,但对其可以作预测.事实上,若预测 y₀ 的最可能取值,则 y₀ 的点预测也是 haty₀.由于 hatβ₀,hatβ₁ 分别是 β₀,β₁ 的无偏估计,因此,haty₀ 也是 E(y₀) 的无偏估计. 为得到 E(y₀) 的区间估计,我们需要知道 haty₀ 的分布.由定理8.4.1 可得
hat y _ 0 = hat β _ 0 + hat β _ 1 x _ 0 ∼ N (β_ 0 + β_ 1 x _ 0, (frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x) σ^ 2),又由定理8.4.3知, Sₑ / σ²∼ χ²(n - 2) ,且与 haty₀ = overliney +hatβ₁(x₀ - overlinex) 相互独立,记
hat σ ^ 2 = frac S _ en - 2,则
frac (hat y _ 0 - E (y _ 0)) / sqrt frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x σsqrt frac S _ eσ^ 2 / (n - 2) = frac hat y _ 0 - E (y _ 0)hat σ sqrt frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x ∼ t (n - 2).于是 E(y₀) 的 1 - α 的置信区间是
[ hat y _ 0 - δ_ 0, hat y _ 0 + δ_ 0 ], (8.4.20)其中
δ_ 0 = t _ 1 - α / 2 (n - 2) hat σ sqrt frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x. (8.4.21)二、 y₀ 的预测区间
Section titled “二、 y₀y0 的预测区间”(8.4.20)式给出了 x = x₀ 时对应的因变量的均值 E(y₀) 的区间估计,实用中往往更关心 x = x₀ 时对应的因变量 y₀ 的取值范围.我们举一个不是非常贴切的例子说明这两者之间的差别: 设想你要去买一台某厂生产的某种型号的液晶电视,则你很关心液晶电视的寿命——它能正常使用多长时间,液晶电视的寿命是一个随机变量,该厂生产的该型号的液晶电视寿命有一个分布,其均值就是它的平均寿命,当然,这是一个重要的质量指标,我们可以对它给出估计,譬如,平均寿命的 0.95 置信区间为 (3,7) (单位: 万小时). 然而,作为消费者,我们更关心的可能是所购买的这台液晶电视的寿命在一个什么范围内,我们所购买的这台液晶电视的寿命是一个随机变量,能否对该随机变量的取值给出一个预测区间呢?这就是我们这里要讨论的预测问题. 事实上, y₀=E(y₀)+ε ,由于通常假定 ε∼ N(0,σ²) ,因此, y₀ 的最可能取值仍然为 haty₀ ,于是,我们可以使用以 haty₀ 为中心的一个区间
[ hat y _ 0 - δ , hat y _ 0 + δ ] (8.4.22)作为 y₀ 的取值范围,为确定 δ 的值,我们需要如下的结果:由于 y₀ 与 haty₀ 独立,故
y _ 0 - hat y _ 0 ∼ N (0, (1 + frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x) σ^ 2).因此有
frac y _ 0 - hat y _ 0hat σ sqrt 1 + frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x ∼ t (n - 2),从而(8.4.22)表示的预测区间中 δ 的表达式为
δ = δ (x _ 0) = t _ 1 - α / 2 (n - 2) hat σ sqrt 1 + frac 1n + frac (x _ 0 - bar x) ^ 2l _ x x. (8.4.23)上述预测区间与 E(y₀) 的置信区间(8.4.21)的差别就在于根号里多个1,计算时要注意到这个差别,这个差别导致预测区间要比置信区间宽很多.
由(8.4.23)式可以看出预测区间的长度 2δ 与样本量n,x的偏差平方和 lₓx,x₀ 到 overlinex 的距离 |x₀-overlinex| 有关.x₀ 愈远离 overlinex ,预测精度就愈差.当 x₀∉[x_((1)),x_((n))] 时,预测精度可能变得很差,在这种情况下的预测称作外推,需要特别小心.另外,若 x₁,x₂,…,xₙ 较为集中时,那么 lₓx 就较小,也会导致预测精度的降低.因此,在收集数据时要使 x₁,x₂,…,xₙ 尽量分散,这对提高精度有利.图 8.4.2(a)给出在不同的x值上预测区间的示意图:在 x=overlinex 处预测区间最短,远离 overlinex 的预测区间愈来愈长,两端呈喇叭状.
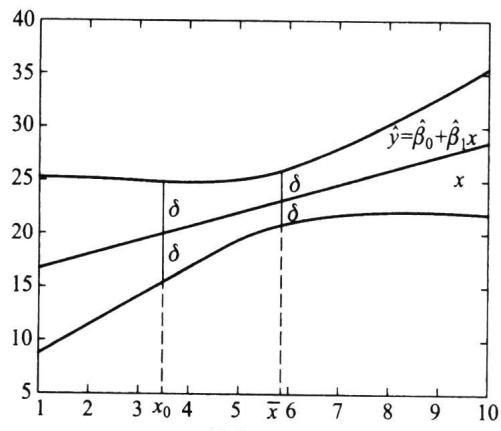
(a) 精确预测区间

(b) 近似预测区间 当 n 较大时(如 n>30),t 分布可以用正态分布近似,进一步,若 x₀ 与 barx 相差不大时, δ 可以近似取为
δ ≈ u _ 1 - α / 2 hat σ, (8.4.24)其中 u₁-α/2 是标准正态分布的 1-α/2 分位数,见图 8.4.2(b).
在例8.4.2 中,如果 x₀=0.16,则得预测值为
hat y _ 0 = 2 8. 1 2 + 1 3 2. 6 6 × 0. 1 6 = 4 9. 3 5.若取 α=0.05 ,则 t₀.975(10)=2.2281 ,又 hatσ=√(17.72/(12-2))=1.3312 ,应用(8.4.21)式,
δ_ 0 = 2. 2 2 8 1 × 1. 3 3 1 2 × sqrt frac 11 2 + frac (0 . 1 6 - 0 . 1 5 8 3) ^ 20 . 0 1 8 6 = 0. 8 6.故 x₀ = 0.16 对应因变量 y₀ 的均值 E(y₀) 的0.95置信区间为
[ 4 9. 3 5 ± 0. 8 6 ] = [ 4 8. 4 9, 5 0. 2 1 ].应用(8.4.23)式,
δ = 2. 2 2 8 1 × 1. 3 3 1 2 × sqrt 1 + frac 11 2 + frac (0 . 1 6 - 0 . 1 5 8 3) ^ 20 . 0 1 8 6 = 3. 0 9,从而 y₀ 的概率为0.95的预测区间为
[ 4 9. 3 5 ± 3. 0 9 ] = [ 4 6. 2 6, 5 2. 4 4 ].我们可以清楚地看到,E(y₀) 的0.95置信区间比 y₀ 的概率为0.95的预测区间窄很多,这是因为随机变量的均值相对于随机变量本身而言波动更小. 如果求近似预测区间,则可按(8.4.24)式计算,由于 u₀.975=1.96,故有 δ≈1.96×1.3312=2.61,则所求区间为
[ 4 9. 3 5 - 2. 6 1, 4 9. 3 5 + 2. 6 1 ] = [ 4 6. 7 4, 5 1. 9 6 ].此处近似预测区间与精确预测区间相差较大,主要是因为 n 较小的原因. 下面我们以一个完整的例子把本节内容重新梳理一遍.
在动物学研究中,有时需要找出某种动物的体积与质量的关系.因为动物的质量相对而言容易测量,而测量体积比较困难,因此,人们希望用动物的质量预测其体积.下面是18只某种动物的体积与质量数据,在这里,动物质量被看作自变量,用x表示,单位为kg,动物体积则作为因变量,用y表示,单位为 dm³ ,18组数据列于表8.4.4中. 表 8.4.4 18 只某种动物的体积 y 与质量 x 数据
| x | y | x | y | x | y |
| 10.4 | 10.2 | 15.1 | 14.8 | 16.5 | 15.9 |
| 10.5 | 10.4 | 15.1 | 15.1 | 16.7 | 16.6 |
| 11.9 | 11.6 | 15.1 | 14.5 | 17.1 | 16.7 |
| 12.1 | 11.9 | 15.7 | 15.7 | 17.1 | 16.7 |
| 13.8 | 13.5 | 15.8 | 15.2 | 17.8 | 17.6 |
| 15.0 | 14.5 | 16.0 | 15.8 | 18.4 | 18.3 |

从散点图我们发现 18 个点基本在一条直线附近,这说明两个变量之间在质量为 10 kg 到 20 kg 内有一个线性相关关系,下面求该线性回归方程,计算过程见表 8.4.5. 表 8.4.5 动物体积与质量数据的计算表
| ∑ xᵢ = 270.1 | n=18 | ∑ yᵢ = 265.0 |
| overlinex = 15.005 6 | overliney = 14.722 2 | |
| ∑ xᵢ² = 4 149.39 | ∑ xᵢ yᵢ = 4 071.71 | ∑ yᵢ² = 3 996.14 |
| n overlinex² = 4 053.000 6 | n overlinex overliney = 3 976.472 2 | n overliney² = 3 901.388 9 |
| lₓx = 96.389 4 | lₓy = 95.237 8 | l_(yy) = 94.751 1 |
| hatβ₁ = lₓy/lₓx = 0.988 1 | ||
| hatβ₀ = overliney - hatβ₁ overlinex = -0.104 8 |
接下来我们考虑关于回归方程的显著性检验.经计算有
S _ T = l _ y y = 9 4. 7 5 1 1,f _ T = 1 7,S _ R = hat β _ 1 ^ 2 l _ x x = 0. 9 8 8 1 ^ 2 × 9 6. 3 8 9 4 = 9 4. 1 0 9 0, f _ R = 1,S _ e = S _ T - S _ R = 0. 6 4 2 1,f _ e = 1 6.把诸平方和移入方差分析表上,继续计算,具体见表8.4.6. 表 8.4.6 动物体积与质量回归方程的方差分析表
| 来源 | 平方和 | 自由度 | 均方 | F比 | p值 |
| 回归 | S_R = 94.109 0 | f_R = 1 | MS_R = 94.109 0 | 2346.9 | 0.000 0 |
| 残差 | Sₑ = 0.642 1 | fₑ = 16 | MSₑ = 0.040 1 | ||
| 总计 | S_T = 94.751 1 | f_T = 17 |
若取 α = 0.05 ,则 t₀.975(16) = 2.1199 ,又 hatσ = √(0.0401) = 0.2002 ,应用(8.4.23)式,
δ = 2. 1 1 9 9 × 0. 2 0 0 2 × sqrt 1 + frac 11 8 + frac (1 7 . 6 - 1 5 . 0 0 5 6) ^ 29 6 . 3 8 9 4 = 0. 4 5 0 2,从而该质量对应动物体积的概率为 0.95 的预测区间为
[ 1 7. 2 8 5 8 - 0. 4 5 0 2, 1 7. 2 8 5 8 + 0. 4 5 0 2 ] = [ 1 6. 8 3 5 6, 1 7. 7 3 6 0 ].用(8.4.24)式可以求近似预测区间,由于 u₀.975=1.96,故有 δ≈1.96×0.2002=0.3924,则所求区间为
[ 1 7. 2 8 5 8 - 0. 3 9 2 4, 1 7. 2 8 5 8 + 0. 3 9 2 4 ] = [ 1 6. 8 9 3 4, 1 7. 6 7 8 2 ].此处近似预测区间与精确预测区间差距已不大了,当 n 更大一些,两者差距会更小一些.
- 假设回归直线过原点,即一元线性回归模型为
E(εᵢ) = 0, Var(εᵢ) = σ²,诸观测值相互独立. (1) 写出 β 的最小二乘估计和 σ² 的无偏估计; (2) 对给定的 x₀ ,其对应的因变量均值的估计为 haty₀ ,求 Var(haty₀) . 2. 设回归模型为
{ l l y _ _ i = β_ _ 0 + β_ _ 1 x _ _ i + ε_ _ i, i = 1, 2, … , n, text 各 ε_ _ i text 独立同分布, text 其分布为 N (0, σ^ 2). .试求 β₀, β₁ 的最大似然估计,它们与其最小二乘估计一致吗? 3. 在回归分析计算中,常对数据进行变换
widetilde y _ i = frac y _ i - c _ 1d _ 1, widetilde x _ i = frac x _ i - c _ 2d _ 2, i = 1, 2, … , n,其中 c₁, c₂, d₁(d₁ > 0), d₂(d₂ > 0) 是适当选取的常数. (1)试建立由原始数据和变换后数据得到的最小二乘估计、总平方和、回归平方和以及残差平方和之间的关系; (2) 证明: 由原始数据和变换后数据得到的 F 检验统计量的值保持不变. 4. 对给定的 n 组数据 (xᵢ, yᵢ), i=1,2,…,n ,若我们关心的是 y 如何依赖 x 的取值而变动,则可以建立回归方程
hat y = a + b x.反之,若我们关心的是 x 如何依赖 y 的取值而变动,则可以建立另一个回归方程
hat x = c + d y.试问这两条直线在直角坐标系中是否重合?为什么?若不重合,它们有无交点?若有,试给出交点的坐标. 5. 为考察某种维尼纶纤维的耐水性能,安排了一组试验,测得其甲醇浓度 x 及相应的“缩醇化度” y 数据如下:
| x | 18 | 20 | 22 | 24 | 26 | 28 | 30 |
| y | 26.86 | 28.35 | 28.75 | 28.87 | 29.75 | 30.00 | 30.36 |
| y | 1 | 1.2 | 1.4 | 1.6 | 1.8 | 2.0 | 2.2 | 2.4 | 2.8 | 3.0 |
| x | 3.08 | 3.76 | 4.31 | 5.02 | 5.51 | 6.25 | 6.74 | 7.40 | 8.54 | 9.24 |
上式也称为回归方程的决定系数. 8. 现收集了 16 组合金钢中的碳含量 x 及强度 y 的数据,求得 overlinex = 0.125, overliney = 45.7886, lₓx = 0.3024, lₓy = 25.5218, l_(yy) = 2432.4566. (1) 建立 y 关于 x 的一元线性回归方程 haty = hatβ₀ + hatβ₁x ; (2) 写出 hatβ₀ 和 hatβ₁ 的分布; (3) 求 hatβ₀ 和 hatβ₁ 的相关系数; (4) 列出对回归方程作显著性检验的方差分析表 ( α=0.05 ); (5) 给出 β₁ 的 0.95 置信区间; (6) 在 x=0.15 时求对应的 y 的 0.95 预测区间. 9. 设回归模型为 { l yᵢ = β₀ + β₁xᵢ + εᵢ, εᵢ ∼ N(0, σ²), . 现收集了15组数据,经计算有
overline x = 0. 8 5, overline y = 2 5. 6 0, l _ x x = 1 9. 5 6, l _ x y = 3 2. 5 4, l _ y y = 4 6. 7 4,后经核对,发现有一组数据记录错误,正确数据为(1.2,32.6),记录为(1.5,32.3). (1) 求 β₀, β₁ 修正后的 LSE; (2) 对回归方程作显著性检验 ( α=0.05 ); (3) 若 x₀=1.1 ,给出对应响应变量的 0.95 预测区间. 10. 在生产中积累了 32 组某种铸件在不同腐蚀时间 x 下腐蚀深度 y 的数据,求得回归方程为
hat y = - 0. 4 4 4 1 + 0. 0 0 2 2 6 3 x,且误差方差的无偏估计为 hatσ² = 0.001452 ,总偏差平方和为0.1246. (1) 对回归方程作显著性检验 ( α=0.05 ), 列出方差分析表; (2) 求样本相关系数; (3) 若腐蚀时间 x=870,试给出 y 的 0.95 近似预测区间. 11. 我们知道营业税税收总额 y 与社会商品零售总额 x 有关.为能从社会商品零售总额去预测税收总额,需要了解两者之间的关系.现收集了如下 9 组数据 (单位: 亿元):
| 序号 | 社会商品零售总额 | 营业税税收总额 |
| 1 | 142.08 | 3.93 |
| 2 | 177.30 | 5.96 |
| 3 | 204.68 | 7.85 |
| 4 | 242.68 | 9.82 |
| 5 | 316.24 | 12.50 |
| 6 | 341.99 | 15.55 |
| 7 | 332.69 | 15.79 |
| 8 | 389.29 | 16.39 |
| 9 | 453.40 | 18.45 |
(2) 建立一元线性回归方程,并作显著性检验 (取 α = 0.05 ), 列出方差分析表;
(3)若已知某年社会商品零售总额为 300 亿元,试给出营业税税收总额的概率为 0.95 的预测区间;
(4) 若已知回归直线过原点,试求回归方程,并在显著性水平 0.05 下作显著性检验.